📌 项目地址:Tracer-Cloud/opensre | ⭐ 13,008 颗星 | 🔧 Python
CI 变红的那一刻,信息量往往只有一句话:某某 job failed。为什么失败、怎么修,CI 系统不告诉你。团队的常见应对是点一下 re-run 碰运气,或者把排查扔给某个有空的高级工程师。时间一长,flaky 检查越积越多,main 长时间红着没人管。
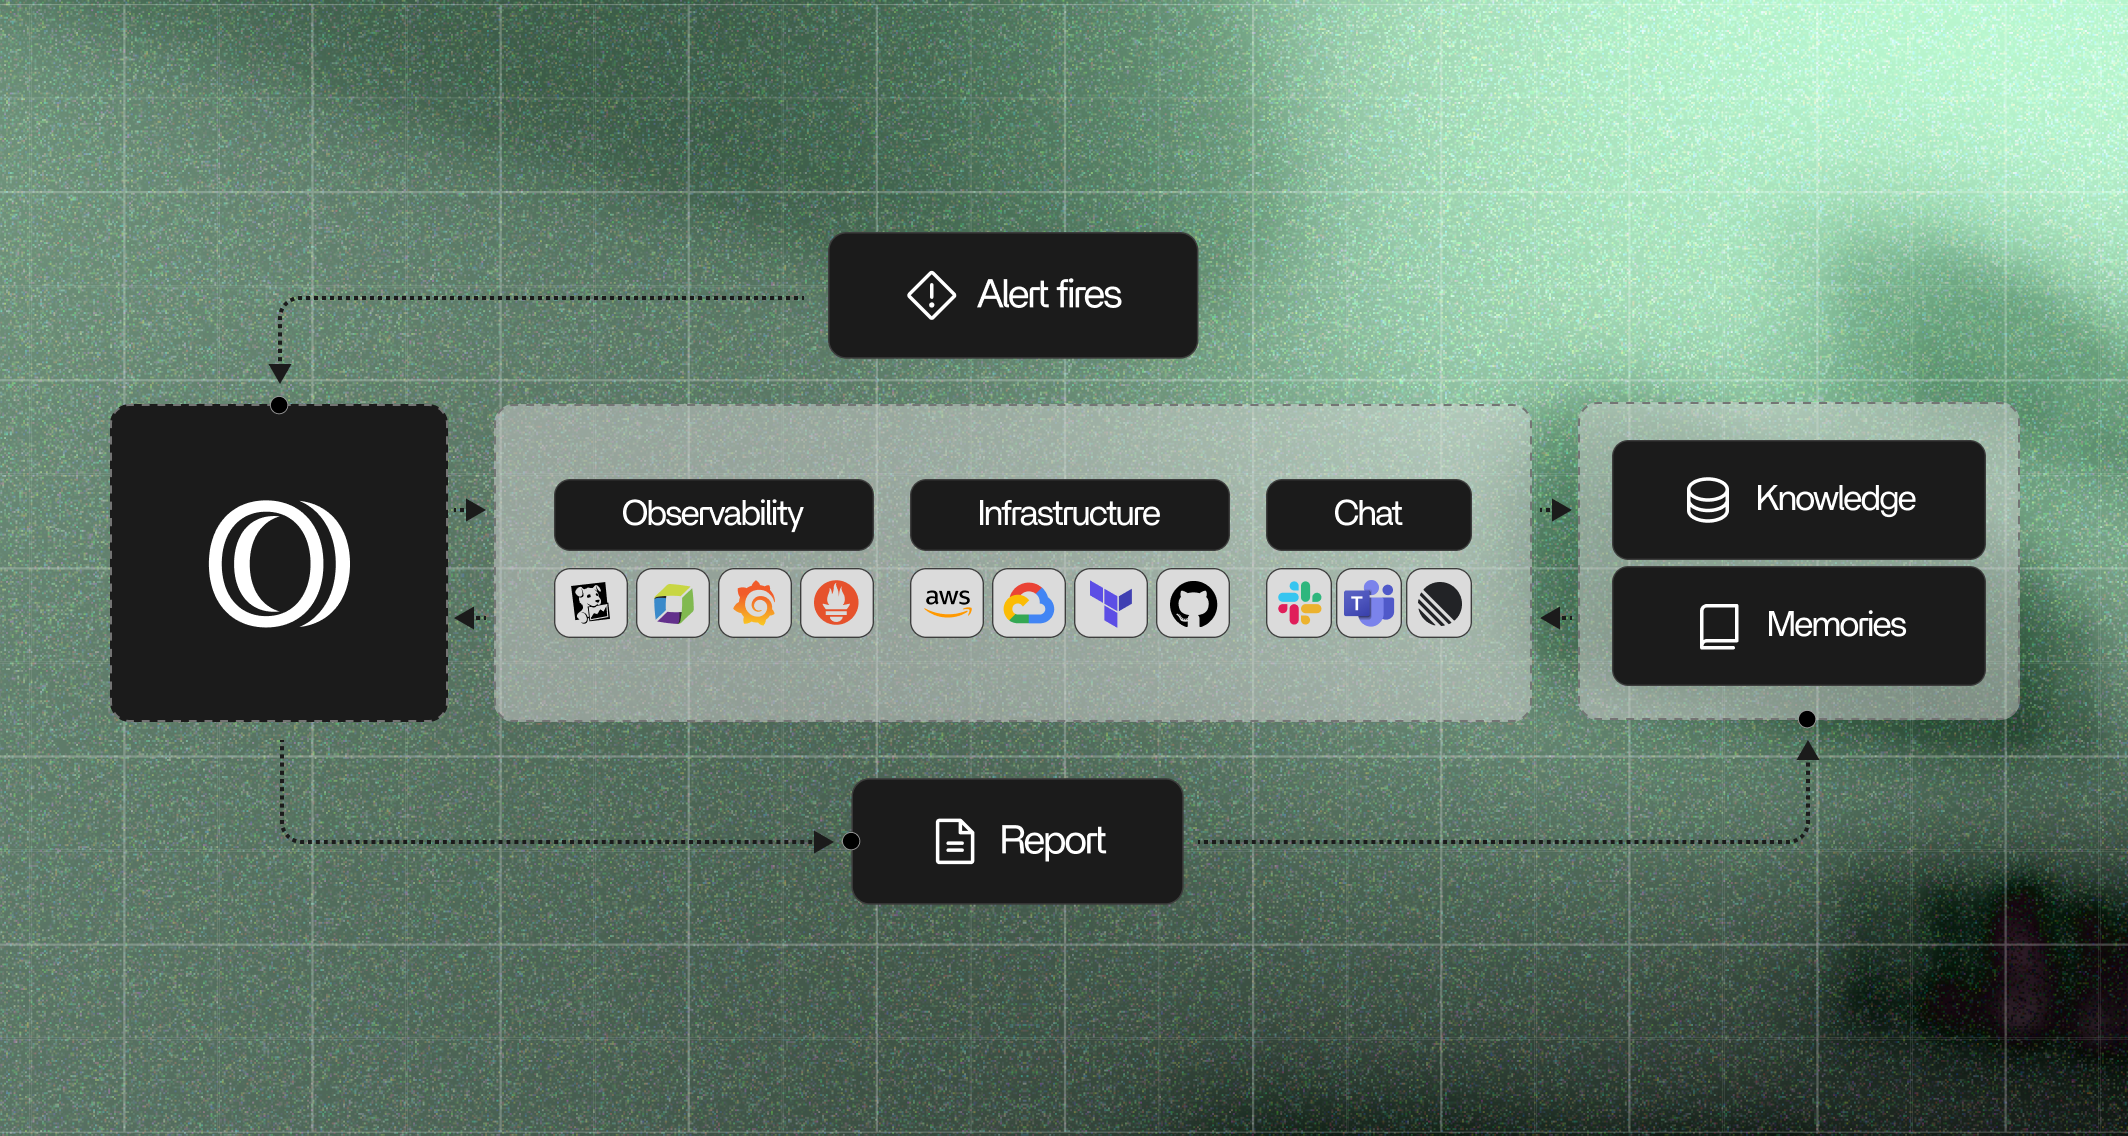
OpenSRE 想接下这个活。它是一个开源的 CI/CD 可靠性 CLI agent:某个 run 失败后,它会读取失败的 run 和日志,测试各种假设,追到根因,然后推送一个修复分支供你审查。注意最后一步是“供你审查”,不是自动合并,改不改仍然由人决定。
它对失败做了个关键区分
CI 失败有两种:CI 本身的问题(环境抖动、网络超时这类)和代码真正引入的问题。两种混在一起,是团队乱点 re-run 的主要原因。OpenSRE 把这两类分开判断,CI 引起的失败和代码引起的失败走不同的处理路径,避免你在错误的方向上花时间。
除了修,它还出账单:失败率多少、工程师因为 CI 不可靠浪费了多少小时、main 平均红多久。这些数字平时没人统计,但对说服管理层投 CI 基建很有用。
自托管,模型自己带
OpenSRE 跑在你自己的基础设施上,接你自己的模型。代码和日志不出你的环境,这一点对内部仓库敏感的团队是硬门槛,也是它和一堆 SaaS CI 修复服务的核心区别。
安装
macOS / Linux 一行装好,不需要 sudo:
curl -fsSL https://install.opensre.com | bash -s -- -gh
Windows 用 PowerShell:
& ([scriptblock]::Create((irm https://install.opensre.com/install.ps1))) -gh
装完直接敲 opensre 启动。如果提示找不到命令,按安装器打印的 PATH 说明处理,或者重开一个终端。前置条件就两个:在代码项目目录下开终端,项目最好是 Git 仓库。
安装器拉的是 main 分支的最新构建,这也侧面说明它还处在快速迭代期。
验证方式有点讲究
作者引用了 SWE-bench 的结论:agent 在真实任务加清晰反馈的环境下进步最快。而流水线失败比本地代码任务更慢、噪声更大、更难复现,所以 OpenSRE 在 tests/e2e 维护覆盖真实云场景的端到端测试,而不是只跑本地模拟。一个 alpha 阶段的项目愿意养真实环境的 e2e 测试,我认为是个好信号。
现在能用吗
项目自己标了 Public Alpha:核心工作流可以跑起来体验,但 API 和集成可能变动。我的建议分两种情况:
如果你的团队经常被红色 main 和 flaky CI 消耗工时,而且有能力自托管,现在就可以装来试,哪怕只用它做失败归因(区分 CI 问题和代码问题),价值已经不小。如果是个人小项目,CI 失败十分钟自己就能看出来,等它稳定些再看。
上生产前记得读一遍 Docs 里的 Security 和 Telemetry 页面,确认遥测到底收集了什么。