📌 项目地址:google-research/paper-orchestra | ⭐ 1,272 颗星 | 🔧 Python
输入是原始材料,不是一句“帮我写论文”
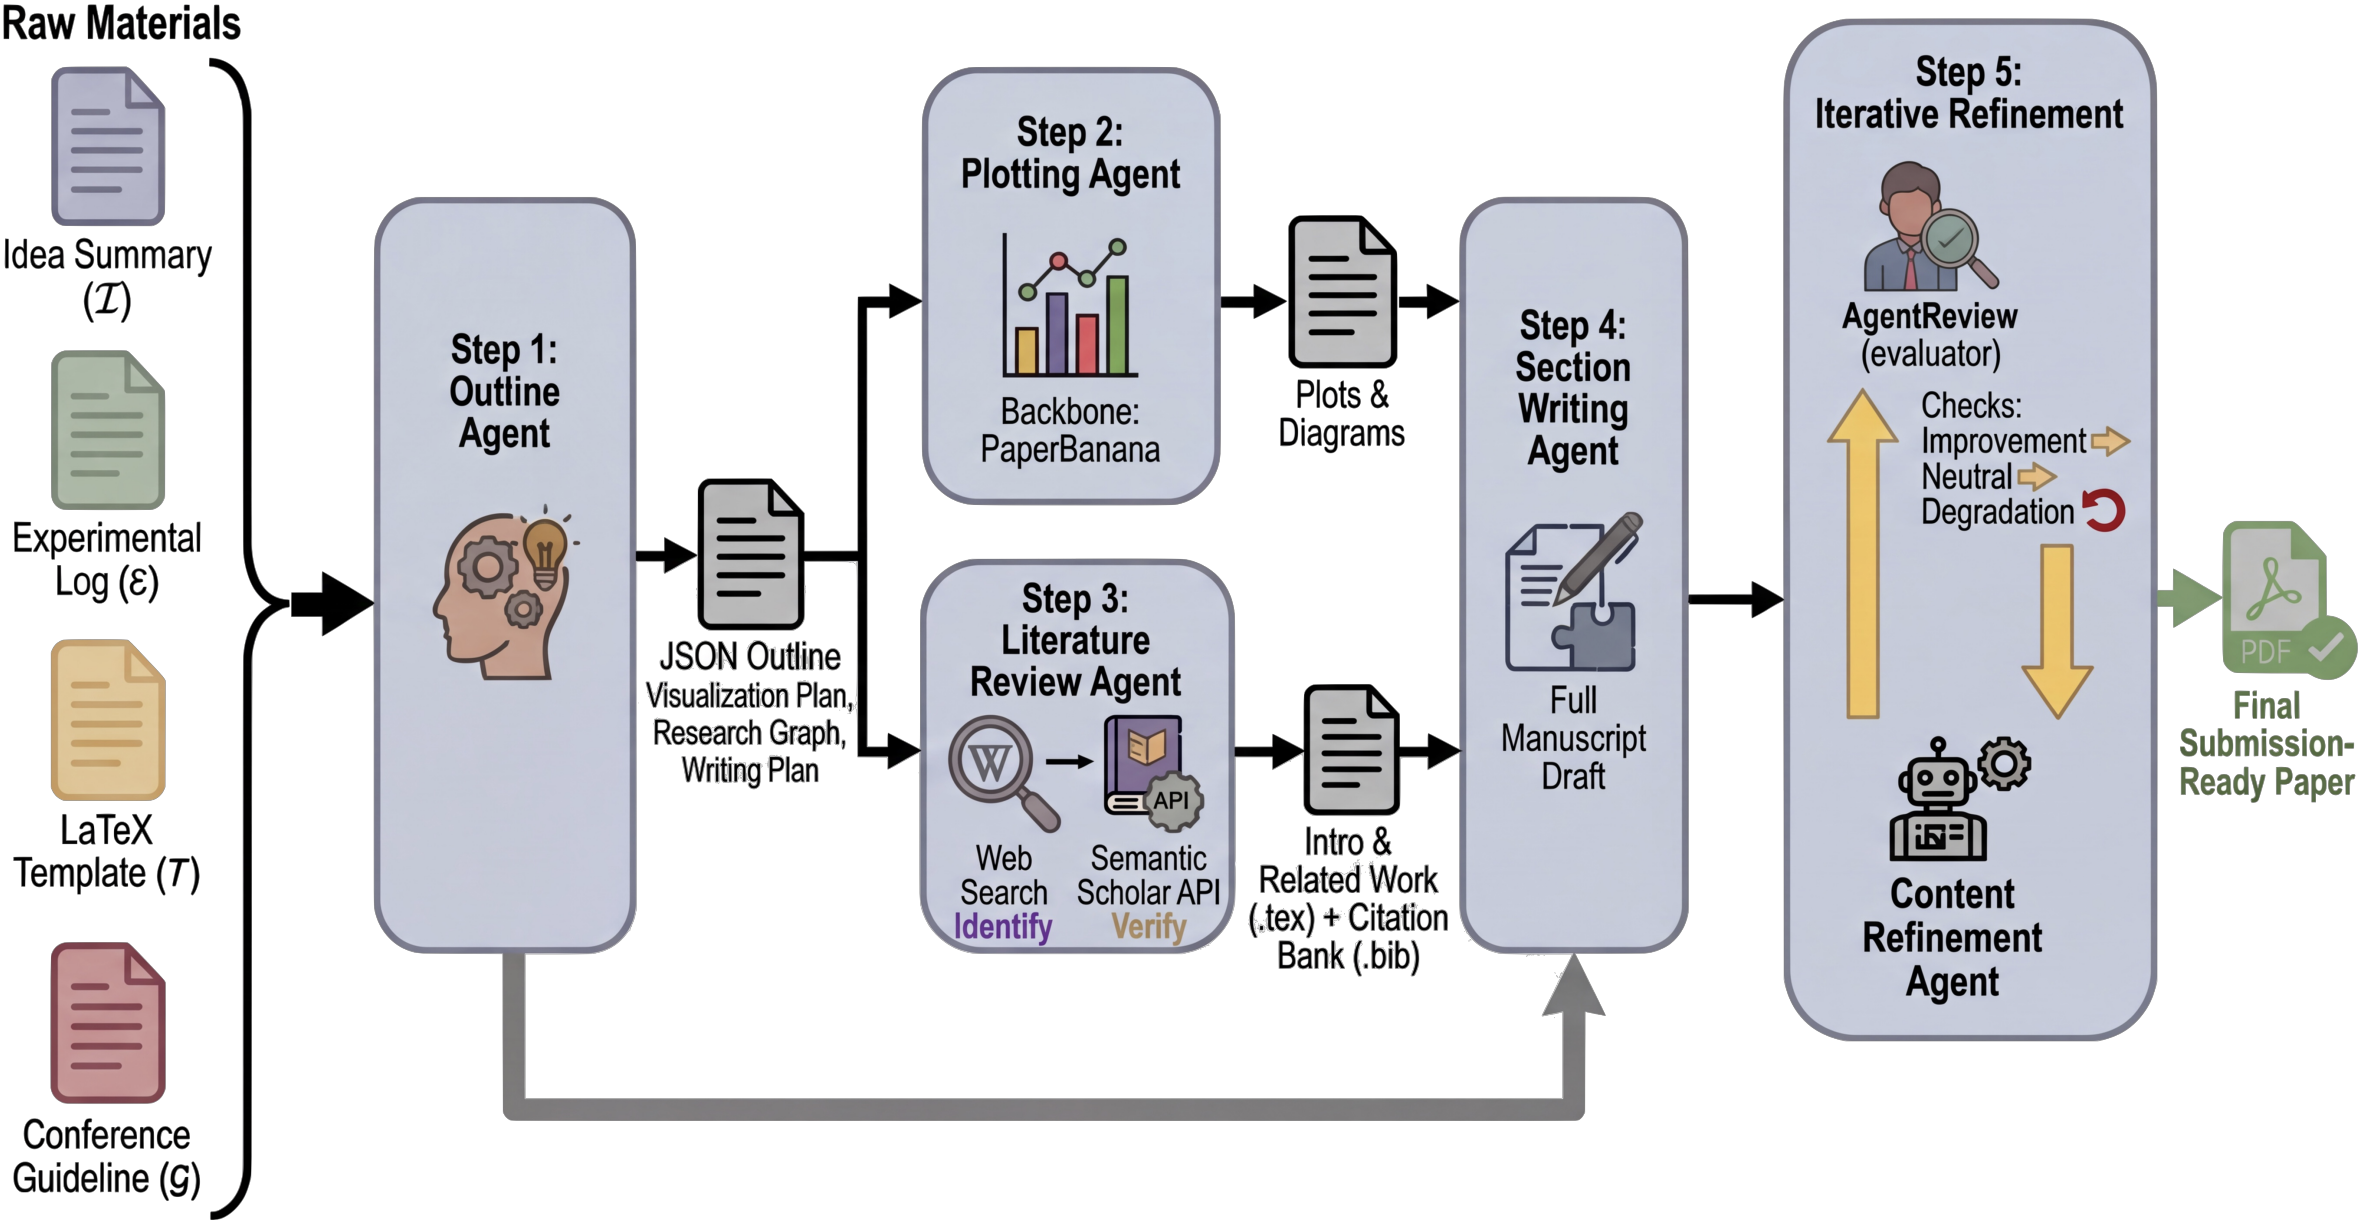
PaperOrchestra 是 Google Cloud AI Research 团队开源的多智能体论文写作框架(Python,一千多 star)。它最值得注意的设计在输入端:你喂给它的不是一句空泛的写作指令,而是研究过程里真实存在的东西,研究想法和实验日志。输出是一份套好目标会议模板的 LaTeX 稿件,包含文献综述和生成的图表。
流水线拆成五个专职环节:
- Outline:先搭论文骨架
- 文献综述:自动检索、按相关性排序、把文献织进正文(依赖 Semantic Scholar 的 API)
- 分章节写作:各 section 分别生成
- 内容精修:对初稿做 refinement
- 绘图:生成实验图表,也支持插入概念示意图
这个拆法就是它和“一个 prompt 塞给大模型”的本质区别。每个环节独立运作,各自有质量控制,而不是指望模型一次输出全部内容。
装和跑
Python 3.11,官方用 Conda:
conda create -n paper_orchestra python=3.11
conda activate paper_orchestra
pip install -r requirements.txt
然后在项目根目录建 .env。密钥按需配:用 Gemini 模型要填 VERTEX_AI_PROJECT + VERTEX_AI_LOCATION,或者直接给 GEMINI_API_KEY;用 OpenAI 模型给 OPENAI_API_KEY;文献检索需要 SEMANTIC_SCHOLAR_API_KEY。想跑 demo 并在结束后收到邮件,再加 SMTP_EMAIL 和 SMTP_PASSWORD。
运行有两种方式:
# 方式一
./paper_writing_cli.sh

# 方式二
python paper_writing_cli.py
  --raw_materials_dir /path_to_your_raw_materials/
  --lat
要说明一点:README 里的 CLI 示例在 --lat 处就断了,后面的参数我看不到,完整用法请以仓库里的 paper_writing_cli.py 为准。我不猜。
现在就能跑,但复现不了官方结果
一个必须提前知道的限制:论文生成用的数据集不随代码发布,官方说之后单独放出,届时下载放进 datasets/ 目录就行。这意味着你现在 clone 下来,只能拿自己的材料(想法笔记加实验日志)去试,没法对照官方实验。想跟进就 watch 仓库等数据集。
它和直接问聊天模型有什么不一样
两点实质差异。
一是输入约束。实验数字来自你的日志,不是模型想象,这从机制上压低了编造数据的空间。通用聊天模型写论文最大的问题就是数字和引用随手就来。
二是文献整合。它会实际去检索、排序、并把相关文献写进正文,聊天模型没有这条检索管道。再加上直接产出符合会议模板的 LaTeX,排版这块机械劳动也省了。
冷静的部分
它解决的是“从材料到稿件”这一段,不替代研究本身。生成内容的学术准确性、引用真实性,还得作者逐条核对。多数会议对 AI 生成内容有披露要求,投稿前务必查一下目标会议的具体政策。
许可证细节看仓库的 LICENSE 文件。