
📌 项目地址:NVIDIA/auto-ontology | ⭐ 10,190 颗星 | 🔧 Python
问题很具体:Agent 会查数,但不知道哪个数是对的
现在的 LLM Agent 检索文档、跑 SQL 都没问题,真正卡住企业落地的是可靠性。一个收入指标,Agent 一秒钟答出来,但数字错了,这一秒钟毫无价值。
Agent 缺的是“上下文层”:数据存在哪、这个指标到底什么含义、该不该用这张表、口径从哪来、和其他系统里的同名指标是不是一回事。NVIDIA Auto Ontology 做的就是这一层。它从企业元数据自动生成本体(ontology),把各系统里打架的定义调和统一,再通过 MCP、CLI 和 API 暴露给任何 Agent 框架。
有一点官方说得很清楚:它是补充,不是替换。你已经有的语义模型可以接进来一起用。
五个动作,一个闭环
项目的能力围绕五个动词组织,这个结构本身就说明了它的设计思路:
- Discover:从元数据生成本体,也能接入已有的本体和语义模型,构建 AI-ready 的知识图谱。
- Ground:给 Agent 提供经过认证的业务含义,指标、实体、关系都算,各系统里定义不一致的地方在这里统一。
- Validate:Agent 生成的查询先对照认证定义和数据血缘校验,每个答案都附带溯源信息。
- Expose:MCP、CLI、API 三种方式对外提供上下文,不绑定任何 Agent 框架。
- Learn:认证过的纠错和使用记录回写本体,团队共享的上下文随着每次提问变好。
我觉得 Learn 这一步是关键。多数语义层方案是静态的,定义写好就放在那;这里把使用过程变成了本体的进化路径。
不只是个库,是一套可部署的完整系统
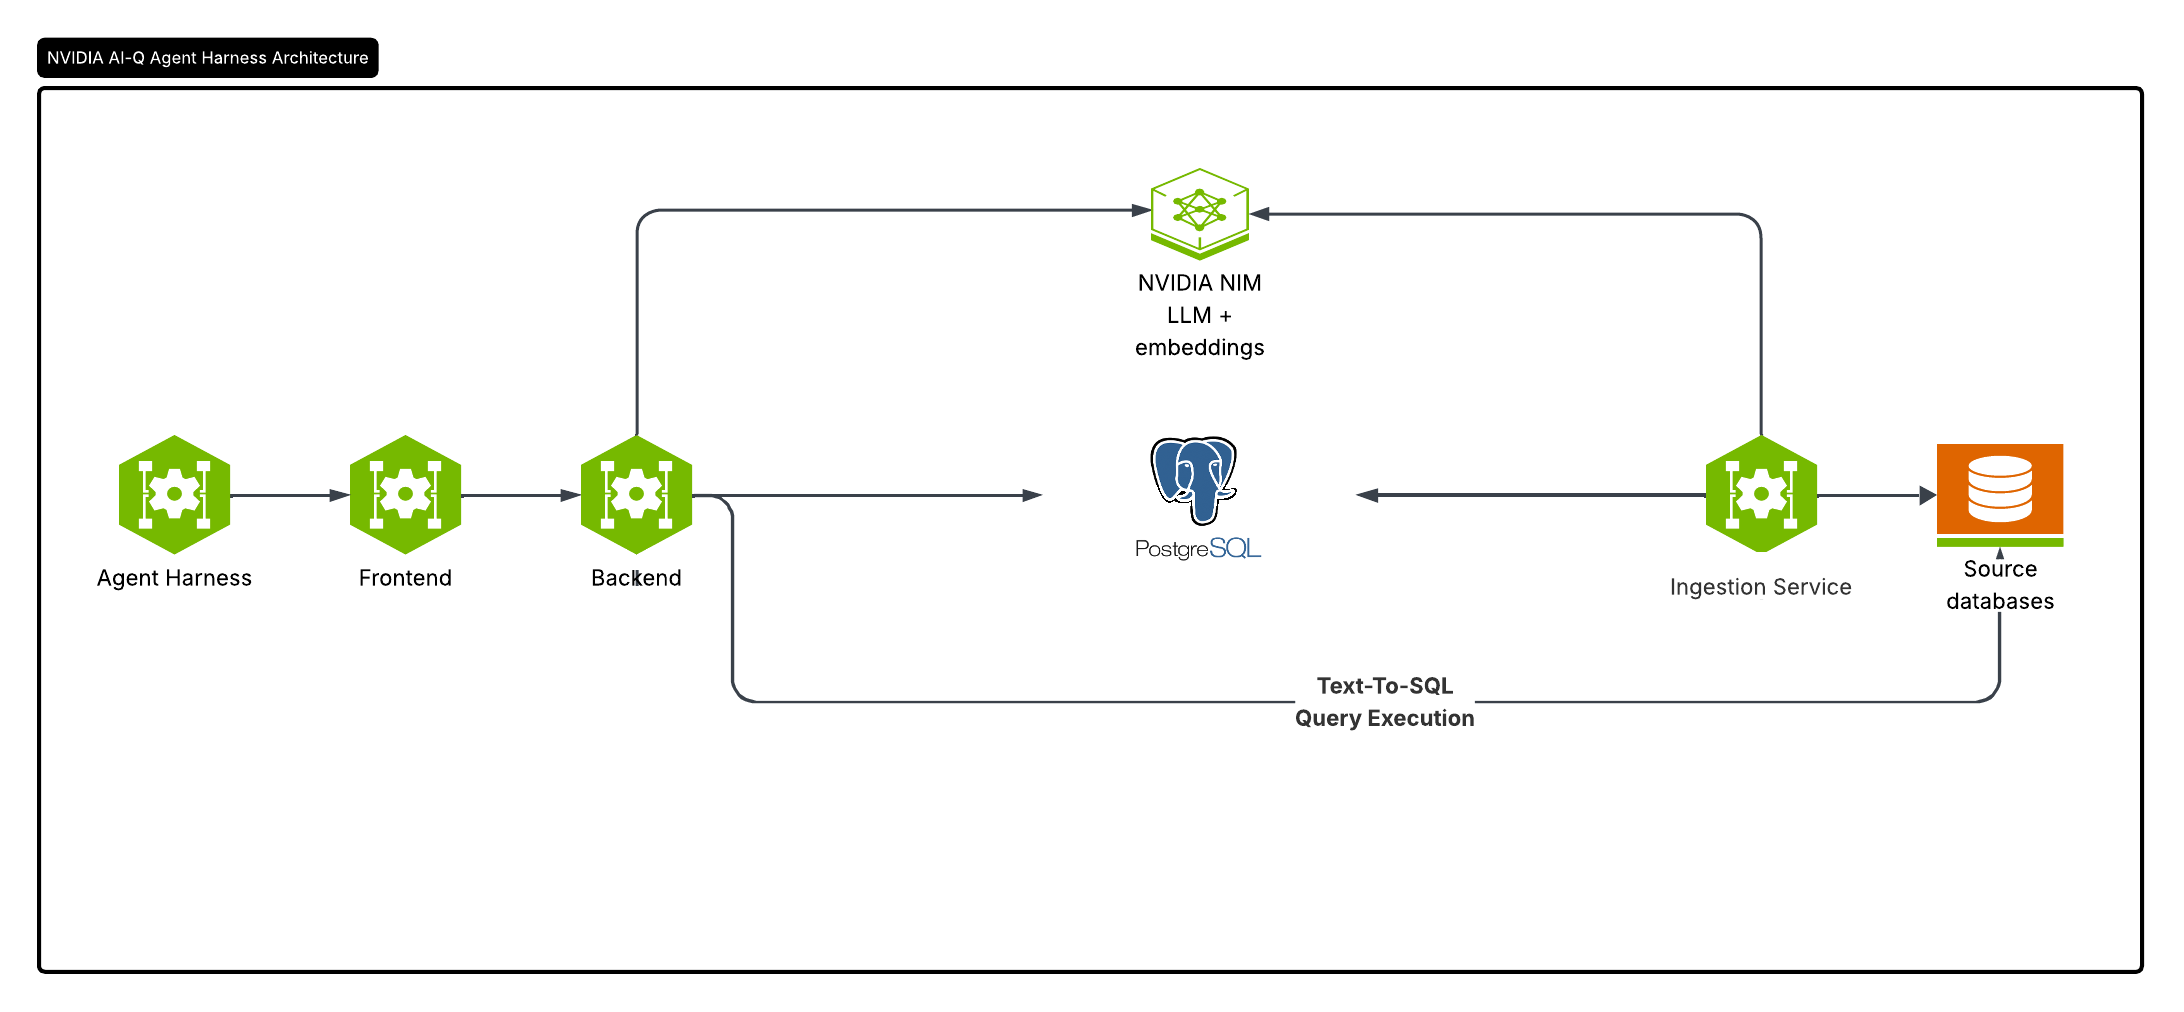
看组件表就明白,这个项目部署形态不轻:
| 组件 | 技术栈 | 职责 | 默认端口 |
|---|---|---|---|
| Frontend | Next.js 16(React 19、TypeScript、Tailwind CSS 4)、Better Auth、Prisma | Web UI、认证、API 网关 | 3000 |
| Backend | FastAPI(Python 3.12+)、LangChain | Chat / NL-to-SQL、数据目录、数据源 API | 3001 |
| Ingestion worker | FastAPI | 元数据摄取 | README 在此截断 |
功能上包括:自然语言查结构化数据(问题翻译成 SQL 执行,由 NVIDIA NIM 驱动)、存在 Postgres 里的语义目录层、基于 Better Auth 的认证和 RBAC、覆盖聊天和分析的数据目录 Web UI。部署走两条路:Kubernetes 用 Helm chart,本地用 Docker Compose。
也就是说,pip install 装完就跑是别想了。它适合有运维能力、想在内部认真做一套 Agent 数据基础设施的团队。
敢给评测路径,这点难得
光讲“提升准确率”概念的项目太多,Auto Ontology 给了可复现的验证方式:独立的评测仓库 ontology-sql-eval,可以跑 BIRD 这类 text-to-SQL 基准,直接测本体层对 NL-to-SQL 准确率的实际影响。想评估它到底有没有用,先跑一遍基准,比读十篇宣传文章都管用。
和语义层产品的区别
dbt semantic layer、Cube 这类产品不是新东西,RAG 加元数据检索的方案也一堆。Auto Ontology 的差异点在这几处:
- 目标是 Agent 的可靠性,不只是查询方便。核心卖点是查询校验加溯源,答案附带来源和定义依据。
- 本体形态包含实体和关系,不只是指标定义,能回答“什么和什么相似”这类问题。
- 学习闭环让共享上下文随使用改进,而不是一份写死的数据字典。
- NL-to-SQL 由 NVIDIA NIM 驱动,这是生态绑定,也可能是性能来源。
上手前要知道的几件事
- 许可证 Apache 2.0,可以商用。但项目目前不接受外部贡献,想给上游提代码或深度定制的,先确认这一点。
- README 本身不完整(组件表在 Ingestion worker 处截断,也没有给出具体安装命令),上手前直接去仓库看完整文档。
- 依赖 NVIDIA NIM 做自然语言转 SQL,不想引入 NVIDIA 推理栈的话,这块需要单独评估。
一句话总结:如果你们团队已经在用 Agent 做数据分析,而且被“答得快但答得错”折磨过,这个项目值得花一天时间部署起来跑个基准看看。它解决的问题足够真实,剩下的就看它在你自己的数据上表现如何。