📌 项目地址:tapdata/tapdata | ⭐ 662 颗星 | 🔧 Java | 📜 Apache-2.0
一句话介绍
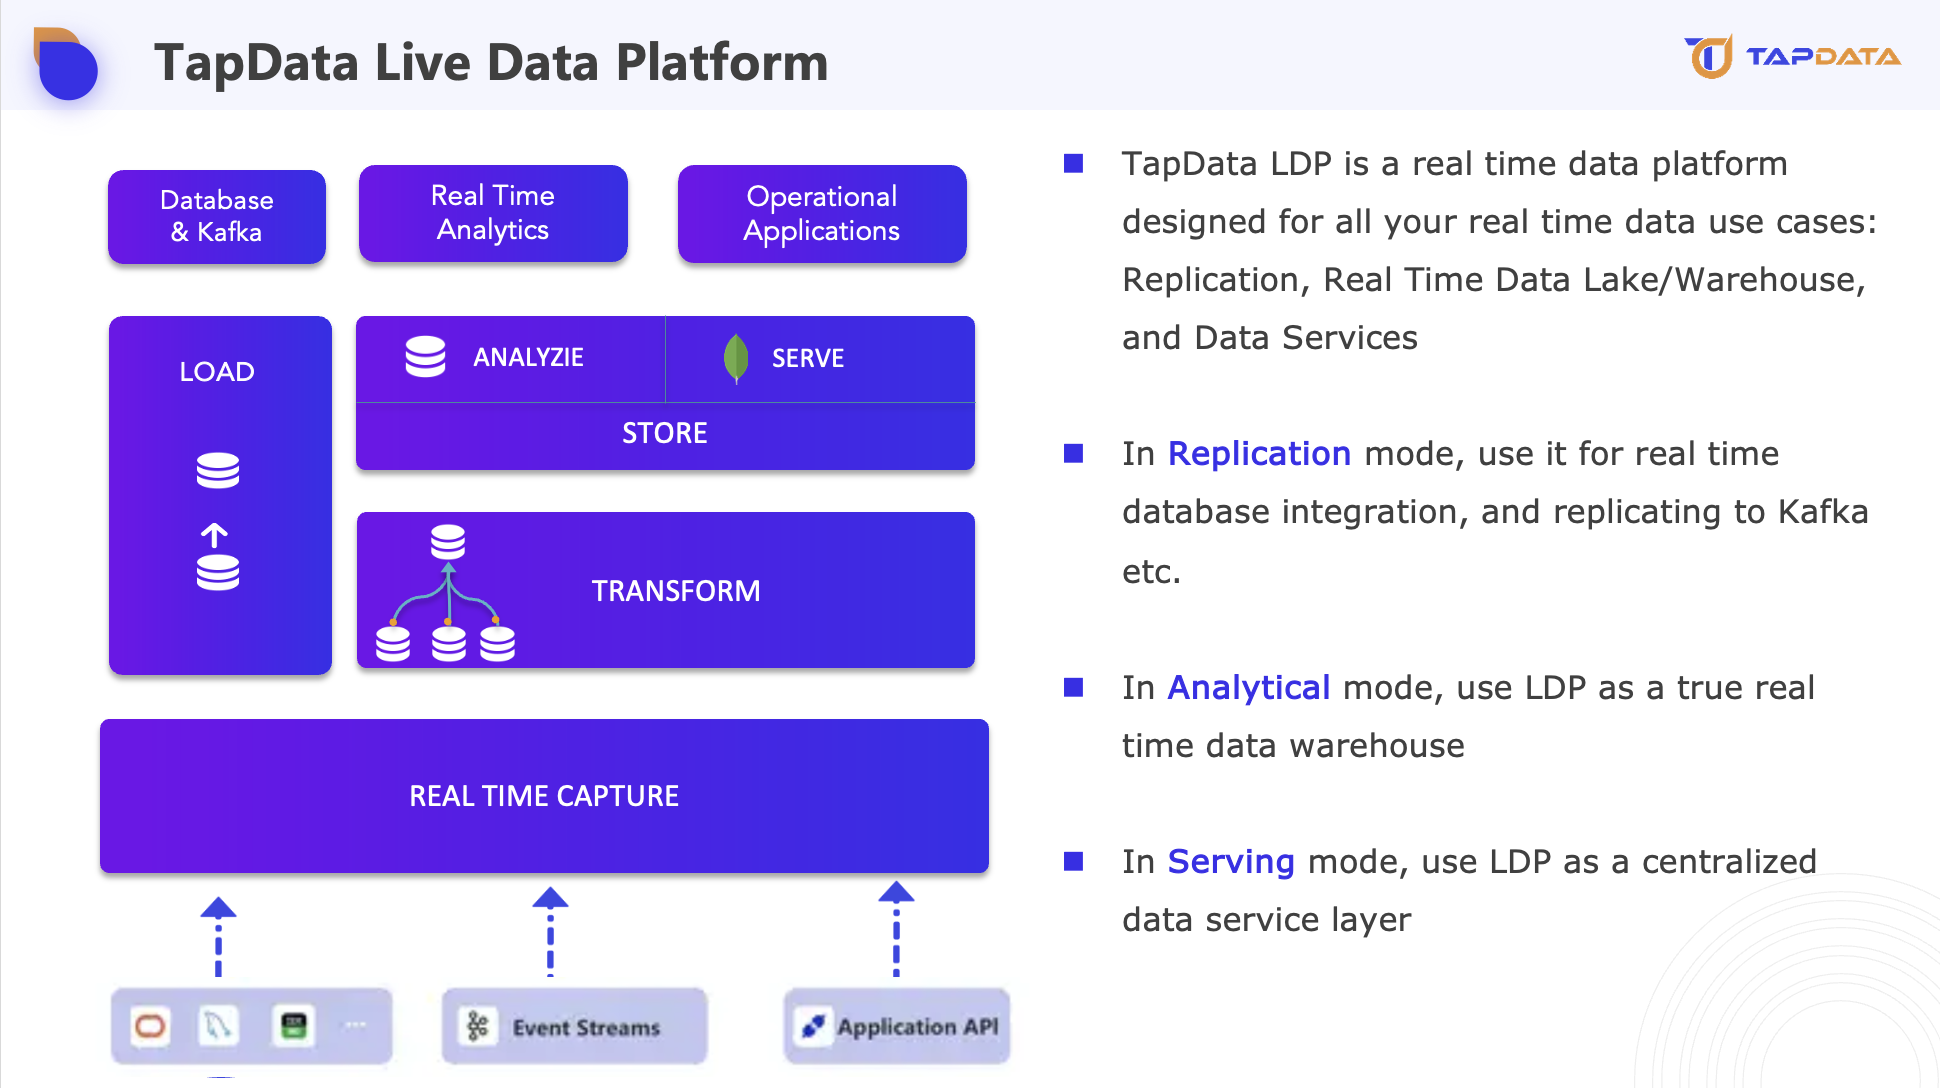
Tapdata 是一个实时数据集成平台,核心思路是 CDC(变更数据捕获):从源库的变更日志里持续抓取增量数据,推送到目标端,让数据库、SaaS 服务、应用、文件之间的数据保持实时同步。
它和传统批处理 ETL 的区别在时效上。批处理通常是 T+1 跑定时任务,数据到分析端时已经过期一天。Tapdata 走 CDC 路线,增量变更持续流动,全量同步完成后自动切到增量模式,中间不需要人工配置切换逻辑。
它实际帮你做了什么
从 README 看,有两点比较明确:
全流程自动化。 目标端的表自动创建,全量同步完成后自动切增量,整个管道从建表到持续同步不需要分段操作。
端到端可视化界面。 同步任务靠拖拽搭建,不用写代码。界面上能看到同步性能、任务进度、关键事件和日志,任务出问题时不用翻服务器日志排查。
支持的数据库和连接器列表在官方文档的 Supported Connectors 页面,不在 README 里,选型前先去确认你要用的数据源是否支持。
怎么上手
README 没有给出安装命令和代码示例,Quick Start 章节直接指向官方文档。能确认的路径有两条:
- 想先看效果:访问 https://cloud.tapdata.net,直接体验云服务版本
- 想本地部署:查 https://docs.tapdata.io 的完整文档
- 需要改源码:仓库有 Build From Source 章节,构建步骤在仓库里
也就是说,这个项目更像“开源了一个可自部署的产品”,而不是“提供一个库让你引入代码”。上手门槛主要在部署,不在编码。
开源的只是社区版,这点要先搞清楚
Tapdata 分三个版本:Community Edition(社区版)、Cloud Service(云服务)、Enterprise Edition(企业版)。GitHub 上这份代码对应的是社区版,功能是三个版本里的子集。
版本差异的官方对比在 https://tapdata.io。如果你评估时用的是云服务或企业版,看中的某些功能(比如某些连接器或管理能力)可能不在开源代码里。部署之前,先在文档站确认你需要的东西社区版有没有,别到部署完才发现缺功能。
和同类工具怎么比
数据同步领域已经有几个成熟方案,Tapdata 的位置可以这样摆:
- Debezium + Kafka Connect:组件化程度高,适合已有 Kafka 体系的团队,但部署链路长,Connector、Sink 都要自己搭。Tapdata 把这些打包成了一个带 UI 的整体,代价是定制空间更小。
- DataX:批量离线同步为主,实时能力弱。Tapdata 主打 CDC 实时链路,两者解决的问题不太一样。
- Airbyte:同样有 UI 和连接器生态,社区规模大得多,但技术栈和 CDC 实现路径不同。
我的判断:团队想少搭基础设施、快速得到一条可视化实时管道,Tapdata 社区版值得试。已经有 Kafka 体系、需要深度定制管道行为的,Debezium 生态更合适。
需要注意的地方
- Star 数 662,社区规模小,遇到问题大概率要靠官方文档和官方渠道,别指望 GitHub Issues 里搜到答案。
- 主语言是 Java,深度二开需要 Java 技术栈。
- 许可证条款在仓库的 LICENSE 文件里,商用前自己确认一遍,别只看二手信息。